Als Beraterin für Digitalisierung und Change erlebe ich immer wieder, wie Organisationen vor der Herausforderung stehen, leistungsfähige lokale Large Language Models (LLMs) wie Llama 2 einzusetzen, ohne Datenschutz oder Produktqualität zu gefährden. In diesem Beitrag skizziere ich ein praxisorientiertes, rollenbasiertes Governance‑Modell, das genau diese Balance möglich macht. Ich schreibe aus der Perspektive der Umsetzerin: Welche Schritte habe ich in Projekten empfohlen? Welche Stolpersteine habe ich gesehen? Wie lassen sich technische, organisatorische und juristische Anforderungen miteinander verbinden?
Warum ein rollenbasiertes Governance‑Modell?
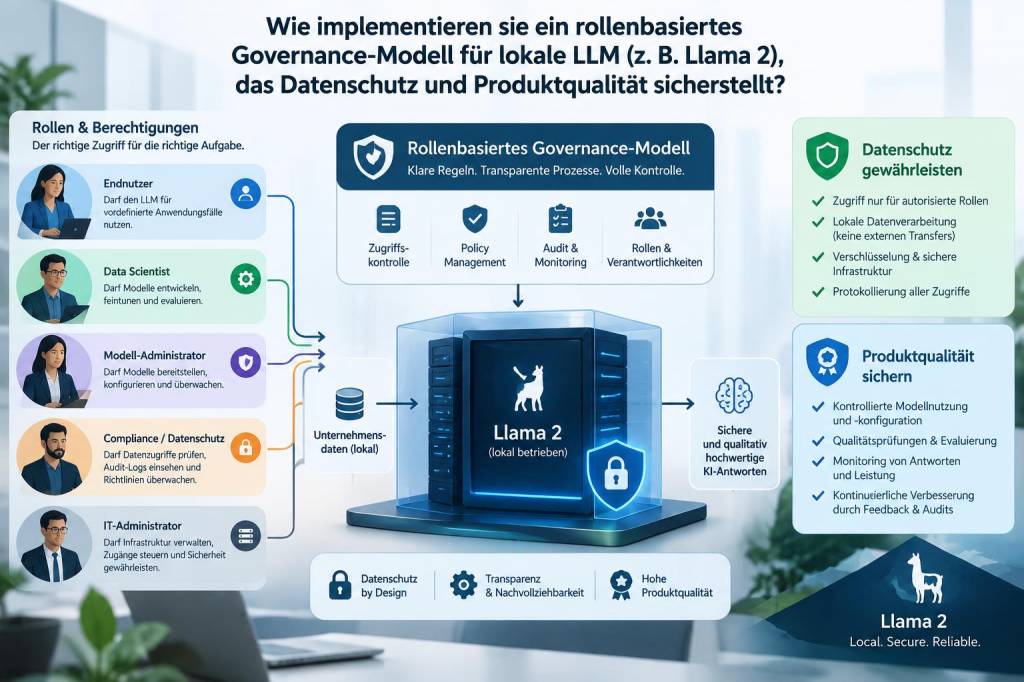
Ein rollenbasiertes Modell schafft klare Verantwortlichkeiten: Wer darf Modelle trainieren oder fine‑tunen? Wer entscheidet über Release, Monitoring und Änderungen? Ohne solche Rollen entstehen Unsicherheiten, die zu Datenlecks, Qualitätsverlust oder rechtlichen Risiken führen können. Ich bevorzuge ein pragmatisches Modell, das sowohl Sicherheit als auch Agilität unterstützt — besonders wichtig bei lokal betriebenen LLMs, die direkten Zugriff auf interne Daten haben.
Kerngedanke: Rollen statt einzelne Personen
Statt auf Einzelpersonen zu setzen, definiere ich Rollen mit klaren Aufgaben, Rechten und Schnittstellen. Rollen lassen sich einfacher auditieren, rotieren und skalieren. Typische Rollen in meinen Projekten sind:
- Data Steward – verantwortet Datenqualität, Datenherkunft und Datenschutzprüfungen.
- ML Engineer – implementiert, betreibt und optimiert das Modell (Fine‑Tuning, Infrastruktur, Pipelines).
- Privacy Officer / DPO – prüft Compliance, führt DPIAs durch und genehmigt Datenflüsse.
- Product Owner – definiert Ziele, KPIs zur Produktqualität und priorisiert Use Cases.
- Model Reviewer / Eval Team – führt qualitative und quantitative Tests durch (Bias, Halluzinationen, Sicherheitslücken).
- Release Manager – koordiniert Deployment, Rollback‑Strategien und Change‑Control.
- Support & Monitoring – betreut Live‑Monitoring, Incident Response und Nutzerfeedback.
Konkrete Aufgaben und Rechte
Damit das Modell funktioniert, definiere ich für jede Rolle explizite Befugnisse. Eine einfache Darstellung hilft beim Onboarding und Audit:
| Rolle | Hauptaufgabe | Entscheidungs‑/Zugriffsrecht |
|---|---|---|
| Data Steward | Kuratiert Trainingsdaten, Pseudonymisierung | Zugriff auf Rohdaten (geschützt), Freigabe von Datensets |
| ML Engineer | Training, Fine‑Tuning, Infrastruktur | Schreibzugriff auf Modell‑Artefakte, kein Zugriff auf Roh‑PII ohne Freigabe |
| Privacy Officer | Compliance‑Prüfungen, DPIA | Veto‑Recht bei data flows, Zugriff auf Audit‑Logs |
| Product Owner | Definiert Produkt‑KPIs | Priorisierung, Freigabe von Releases |
| Model Reviewer | Evaluation, Testpläne | Stopp‑Recht bei Qualitäts‑/Sicherheitsproblemen |
| Release Manager | Deployment & Rollback | Zugriff auf Produktionsumgebung, Change‑Log |
Technische Maßnahmen, die ich immer empfehle
Rollen alleine genügen nicht — sie brauchen technische Unterstützung:
- Isolierte Umgebungen: Entwicklungs-, Test‑ und Produktionsumgebungen strikt trennen. Container (z. B. Docker, Kubernetes Namespaces) helfen, Zugriffsrechte technisch zu erzwingen.
- Secrets‑Management: Verwenden Sie Vault‑Lösungen (HashiCorp Vault, AWS Secrets Manager) statt hardcodierter Tokens.
- Feingranulare Zugriffskontrolle: RBAC für Repositories, Modelle und Datenquellen (z. B. GitLab/GitHub + OIDC für Identität).
- Audit‑Logs: Jede Aktion (Datentransfer, Training, Inference) wird geloggt und periodisch geprüft.
- Data Lineage & Pseudonymisierung: Automatische Nachverfolgbarkeit der Datenherkunft und irreversible Maskierung von PII vor Training.
Datenschutz: Praxisfokus für lokale LLMs
Bei lokalem Betrieb liegt Verantwortung ganz bei Ihnen. Das heißt in der Praxis:
- Vor jedem Trainingslauf führe ich eine DPIA durch: Welche personenbezogenen Daten könnten involviert sein? Gibt es alternative, weniger riskante Datensätze?
- Standardmäßig pseudonymisieren oder anonymisieren. Nur in Ausnahmefällen und mit expliziter Genehmigung des Privacy Officer werden Rohdaten verwendet.
- Einwilligungen und Verarbeitungszwecke dokumentieren — nicht „auf Vorrat“ sammeln.
- Vertragliche und organisatorische Schutzmaßnahmen für Third‑Party Tools (z. B. Fine‑Tuning‑Services). Wenn externe Services verwendet werden, nur mit Auftragsverarbeitungsvertrag und geprüftem Hosting‑Standort.
Qualitätssicherung und Evaluationskaskade
Produktqualität messe ich in mehreren Stufen:
- Automatisierte Tests: Unit‑Tests für Prompt‑Pipelines, Regressionssuite gegen Referenzantworten.
- Benchmarking: Metriken wie F1/ROUGE für spezifische Aufgaben, Prompt‑Robustheitstests, Latency‑SLA.
- Human‑in‑the‑Loop: Regelmäßige Reviews durch das Model Reviewer Team, qualitative Tests zu Safety, Bias und Halluzination.
- Live‑Monitoring: Telemetrie zu Fehlerraten, Nutzerfeedback und Anomalien (z. B. ungewöhnliche Input‑Korrelationen).
Prozessbeispiele aus der Praxis
Ich teile gern zwei typische Prozessabläufe, die sich in Projekten bewährt haben:
- Release‑Gate: Data Steward & Privacy Officer prüfen Datensatz → ML Engineer führt Training in Sandbox durch → Model Reviewer bewertet auf vordefinierten Metriken → Product Owner genehmigt → Release Manager deployed in Staging → 7‑tägiges Dark Launching mit Live‑Monitoring → Produktionsfreigabe.
- Incident Workflow: Support meldet Auffälligkeit → Release Manager initiiert Hotfix‑Branch → ML Engineer und Model Reviewer analysieren Ursache → Privacy Officer prüft Datenaspekte → Rollback falls nötig; Lessons Learned dokumentiert.
Governance‑Tooling und Integration
Für Transparenz und Automatisierung setze ich auf eine Toolchain, die Rollen abbildet und Workflows orchestriert. Beispiele:
- GitOps (ArgoCD/Flux) für Infrastruktur‑Versionierung
- CI/CD (GitHub Actions/GitLab) mit genehmigungspflichtigen Pipelines
- Data Catalogs (Amundsen, DataHub) zur Nachverfolgbarkeit
- Monitoring (Prometheus, Grafana) + Sentry/ELK für Logs
- Policy Engines (Open Policy Agent) für automatische Policy‑Checks
Change Management: Menschen und Kultur
Technik und Prozesse bringen wenig, wenn die Kultur fehlt. Aus meiner Erfahrung sind diese Schritte entscheidend:
- Klare Kommunikation der Rollen, Erwartungen und Eskalationswege.
- Schulungen für alle beteiligten Rollen: Datenschutz, sichere Entwicklung, Prompt‑Engineering.
- Regelmäßige Reviews und Retrospektiven, um Governance iterativ zu verbessern.
- Belohnungssysteme für Compliance und Qualität (z. B. Recognition für „sichere Releases“).
Ein rollenbasiertes Governance‑Modell ist kein starres Regelwerk, sondern ein vernetztes System aus Verantwortung, technischen Kontrollen und Kultur. Indem ich Rollen klar definiere, technische Maßnahmen automatisiere und Menschen gezielt befähige, habe ich mehrfach sichere, datenschutzkonforme und qualitativ hochwertige LLM‑Projekte aufgesetzt. Wenn Sie möchten, kann ich Ihnen ein Template für Rollenbeschreibungen und eine Checkliste für DPIAs zuschicken — das hilft beim schnellen Start in Ihr eigenes Governance‑Vorhaben.